Actualizado el
MCP, llms.txt y WebMCP: tres formas de que un agente entienda tu web (y cuál necesitas)
No compiten: cada una sirve según dónde esté el agente. Las montamos en nuestra web y medimos bytes y tokens, incluido el caso en que MCP sale más caro.
Actualización del 19 de octubre de 2026. Volvimos a medir contra producción y esta vez contamos tokens, no solo bytes. Cambia una conclusión: con el texto ya extraído, leer
/preciosle cuesta a un agente menos contexto que nuestra herramienta MCP; donde MCP sí ahorra es en las preguntas estrechas, como una definición. También corregimos varias afirmaciones de la primera versión: el catálogo de herramientas no ocupa contexto en todos los clientes, el registro oficial sí hace descubrible un servidor MCP para los clientes MCP, Google Search ignora el llms.txt y llamar anavigator.modelContexten un navegador sin la API lanza un error. Los datos de la medición se pueden descargar.
Resumen ejecutivo
- No son tres fases de lo mismo. El llms.txt describe, MCP ejecuta y WebMCP actúa dentro de la pestaña. La pregunta que las separa no es cuál es más moderna, sino dónde está el agente cuando necesita algo de ti.
- Montamos un servidor MCP público en nuestra web y lo medimos contra producción, en bytes y en tokens. Para responder «qué servicios hay y cuánto cuestan», la herramienta MCP mueve doce veces menos bytes que la página
/precios(12.231 frente a 152.007). Pero una vez extraído el texto, la página son 1.172 tokens y la herramienta 1.779, porque trae las tarifas de todos los países. MCP ahorra contexto cuando la pregunta es estrecha: una definición del glosario son 205 tokens por herramienta frente a 1.515 por la página. - El coste que nadie cuenta: el catálogo de nuestras cinco herramientas son 26.147 bytes, 6.487 tokens, que el agente paga aunque no llame a ninguna si su cliente mete el catálogo entero en el contexto. Los clientes con carga diferida solo cargan lo que van a usar. Cinco herramientas se aguantan; cuarenta sin carga diferida, no.
- WebMCP no está en ningún navegador estable. Origin trial en Chrome 149 desde el 9 de junio de 2026 y en Edge 150; Chrome Status lo clasifica como «Proposed» e «Incubation»; Mozilla es neutral y WebKit se opone. Y la API es
document.modelContext, nonavigator.modelContextcomo repiten medio internet y bastantes generadores de contenido. - Si solo puedes hacer una cosa esta semana, no es ninguna de las tres: es que tu contenido sea legible sin ejecutar JavaScript. Las tres capas dan por supuesto lo que a la mayoría de las webs le falta.
Desde que el Model Context Protocol se hizo popular, en cada conversación sobre visibilidad en IA aparece la misma pregunta mal formulada: «¿tengo que poner MCP, llms.txt o eso nuevo del navegador?». Está mal formulada porque asume que son alternativas, cuando en realidad ni siquiera operan en el mismo punto del recorrido.
He implementado las tres en esta web —dos en producción, la tercera a modo de prueba— y he medido lo que cuestan. Lo que sigue es el criterio para decidir, con los números delante.
Las tres, en una frase cada una
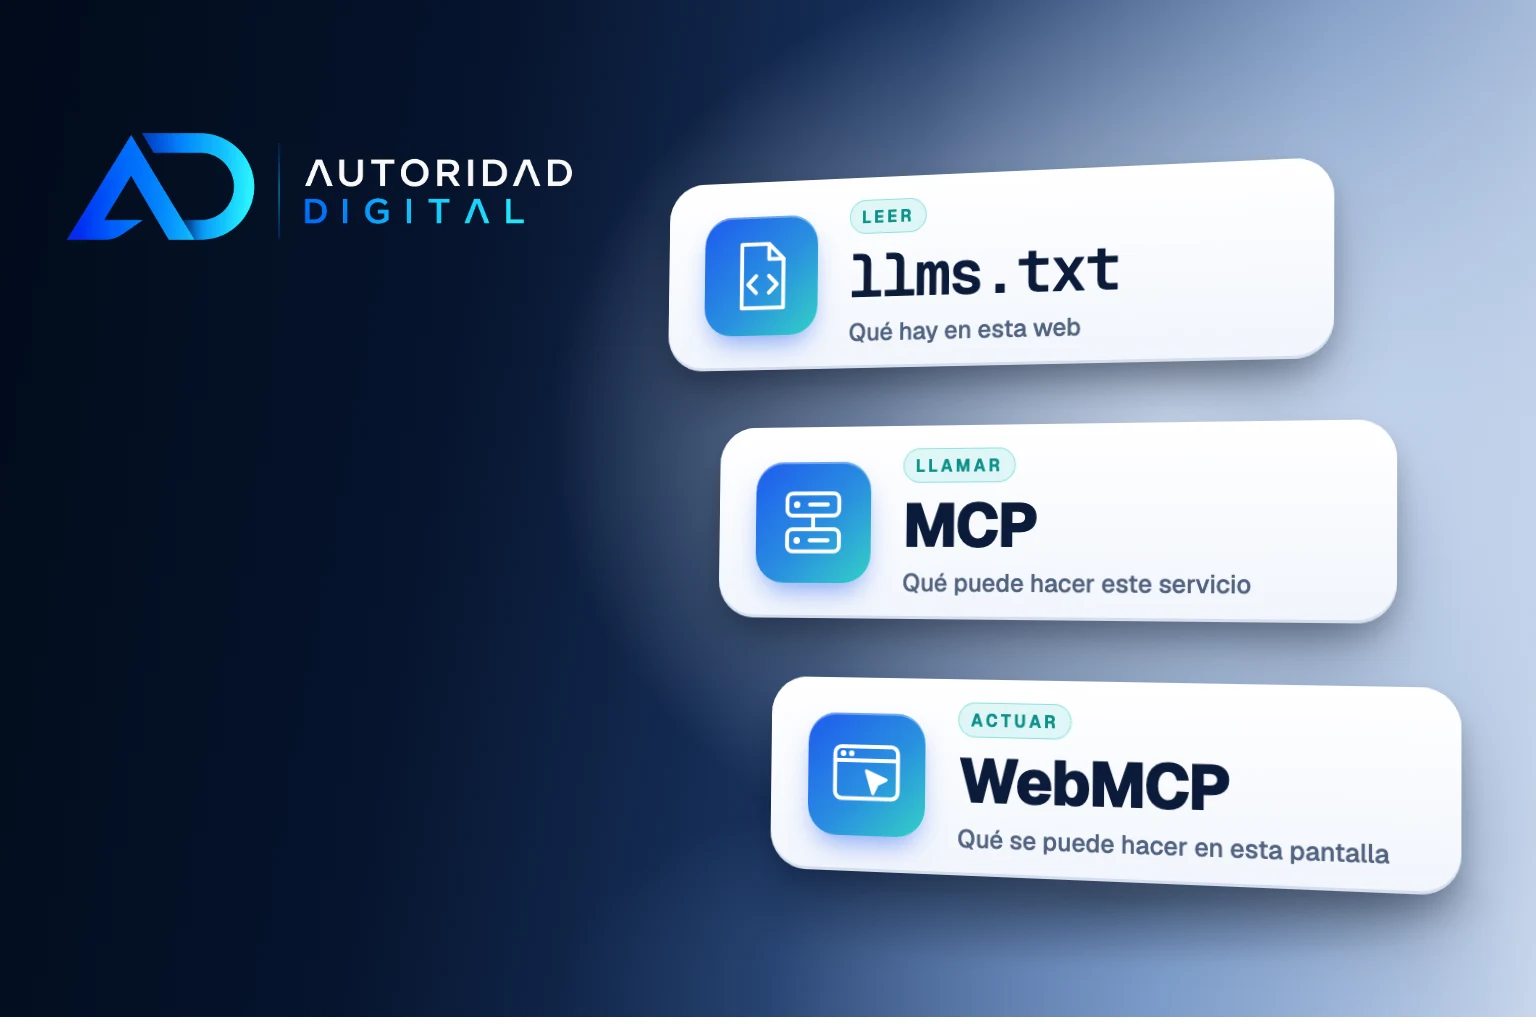
| llms.txt | MCP | WebMCP | |
|---|---|---|---|
| Qué es | Un fichero de texto en la raíz | Un servidor remoto que expone herramientas | Una API del navegador dentro de tu página |
| Qué responde | Qué hay en esta web | Qué puede hacer este servicio por ti | Qué puede hacer el usuario en esta pantalla |
| Dónde está el agente | Leyendo tu contenido | En otra aplicación, llamando a tu backend | Dentro de la pestaña, con la sesión iniciada |
| Quién lo consume | Un humano que lo pega; algún crawler | Clientes MCP: Claude, ChatGPT, Cursor, IDEs | El agente integrado en el navegador |
| Estado | Propuesta sin adopción confirmada | Estándar de facto, revisión 2026-07-28 | En incubación, origin trial |
| Esfuerzo | Media hora | Días | Horas por formulario |
| Dónde se encuentra | En la raíz de tu dominio | En el registro oficial de MCP y en directorios | En tu página, cuando el agente ya está en ella |
| Te hace más visible en buscadores | No | No | No |
La última fila es la que más discusiones ahorra. Ninguna de las tres te hace más visible por sí misma. No hay crawler que premie un llms.txt —Google dice expresamente que su buscador lo ignora—, ningún buscador usa tu servidor MCP como fuente aunque esté en el registro oficial y ninguno ordena resultados por si declaras herramientas WebMCP. El registro hace que un servidor MCP sea encontrable para quien busca herramientas desde un cliente MCP: eso es descubrimiento dentro de ese ecosistema, no visibilidad en buscadores. Las tres mejoran lo que ocurre después de que alguien te haya encontrado. Quien te las venda como canal de adquisición te está vendiendo otra cosa.
El único criterio que decide: dónde está el agente
Olvida las siglas un momento y responde a esta pregunta sobre tu negocio: cuando un agente de IA necesita algo de ti, ¿dónde está físicamente?
Hay tres respuestas posibles y cada una tiene su capa.
Está leyendo tu contenido, desde un índice o desde una cita. El agente no interactúa: extrae. Le importa que el texto esté en el HTML inicial, que las afirmaciones sean autocontenidas y que la marca esté declarada como entidad. Aquí la herramienta es el contenido mismo, el schema JSON-LD y, marginalmente, el llms.txt. Es el caso de la mayoría de las webs informativas y corporativas, y es donde se juega la citación en motores generativos.
Está en otra aplicación y quiere que hagas algo por él. El usuario está hablando con Claude o con ChatGPT, no ha abierto tu web y probablemente no la abra. Si lo que ofreces es un cálculo, una búsqueda sobre datos que solo tú tienes o una consulta a tu catálogo, un servidor MCP convierte eso en una herramienta invocable. Si lo que ofreces es solo información, no hace falta: para eso está el HTML.
Está dentro de tu pestaña, con la sesión del usuario abierta. Este es el caso que ni el HTML ni MCP resuelven bien. El agente ve la página, el usuario ha iniciado sesión, hay estado en el cliente —un carrito, un filtro aplicado, un formulario a medio rellenar— y la alternativa actual es que el agente simule clics sobre el DOM. Para eso es WebMCP, y para nada más.
Esa tercera categoría es más pequeña de lo que el ruido sugiere. Si tu web es un sitio de servicios con un formulario de contacto, vives casi entera en la primera.
llms.txt: lo barato que puede que no sirva
Le dedicamos un artículo entero y la conclusión no ha cambiado: Ahrefs analizó en mayo de 2026 los 137.210 dominios de su panel y encontró que el 97 % de los ficheros llms.txt válidos no recibió ni una sola petición en un mes. Ninguna plataforma ha confirmado públicamente que lo use, y Google ha dicho lo contrario: su guía de optimización para las funciones de IA generativa dice que Google Search no usa estos ficheros, que no hace falta crearlos para aparecer en sus funciones de IA y que tenerlos ni ayuda ni perjudica.
Lo mantenemos igualmente, por dos motivos que sí se sostienen y conviene separar del marketing:
- Como contexto que se pega a mano. Cuando alguien quiere que un modelo entienda nuestra web entera, pegar 37.952 bytes de resumen estructurado (9.134 tokens) funciona mucho mejor que pedirle que navegue. Ese uso es real y es el que tiene hoy.
- Como fuente canónica interna. Nuestro
llms.txtse genera del mismo sitio del que sale la web, así que no es contenido paralelo que mantener. Volveremos sobre esto, porque es la diferencia entre que esto sume o reste.
En cifras de esta web: /llms.txt pesa 37.952 bytes y /llms-full.txt —la versión con el contenido completo— 148.136. Ese segundo fichero es del tamaño de una sola de nuestras páginas HTML, y contiene todo el sitio. Esa proporción es el argumento entero a favor del formato.
Media hora de trabajo, puntos en la mayoría de escáneres del mercado —incluido el nuestro, que le da cuatro de cien— y ninguna evidencia de impacto en citación. Es opcional: tiene sentido si lo vas a usar como contexto, si publicas documentación técnica o si alguna herramienta que usas lo lee. No lo hagas para posicionar, y no lo cuentes como una victoria.
MCP: lo montamos y estas son las cifras
El Model Context Protocol es lo más maduro de los tres: revisión actual de la especificación 2026-07-28, implementaciones en todos los clientes relevantes y un registro oficial. Nuestro servidor está publicado allí desde el 10 de septiembre de 2026 con el identificador com.autoridaddigital.www/geo (versión 1.2.1 desde el 28 de septiembre), y responde en https://www.autoridaddigital.com/api/mcp por Streamable HTTP, sin autenticación y sin estado.
Expone cinco herramientas —escanear una web, comparar varias, consultar el glosario, buscar en el blog y devolver servicios y precios—, dos flujos guiados y el llms.txt como recurso. Todo de solo lectura y todo leído de las mismas constantes que renderizan la web.
Lo que cuesta responder una pregunta
Aquí está la medición que importa, hecha contra producción con curl el 19 de octubre de 2026 (la primera versión de este artículo, del 20 de septiembre, solo contaba bytes). La pregunta es la misma en todos los casos: «¿qué servicios ofrece esta agencia y cuánto cuestan?».
Hay que medir dos cosas distintas. Los bytes son lo que viaja por la red. Los tokens son lo que acaba en la ventana de contexto del modelo, y casi ningún agente le pasa el HTML en bruto: lo limpia antes y se queda con el texto. Contamos los tokens con o200k_base, el tokenizador público de OpenAI; el de Claude cuenta distinto, pero los órdenes de magnitud se mantienen.
| Vía | Bytes transferidos | Texto | Tokens |
|---|---|---|---|
HTML de /precios, en bruto | 152.007 | — | 43.837 |
HTML de /precios, texto extraído | 152.007 | 5.453 caracteres | 1.172 |
llms.txt (todo el sitio) | 37.952 | 37.441 caracteres | 9.134 |
Herramienta servicios_y_precios | 12.231 | 7.565 caracteres | 1.779 |
Catálogo tools/list (cinco herramientas) | 26.147 | — | 6.487 |
Medido contra www.autoridaddigital.com el 19 de octubre de 2026, con el tokenizador o200k_base. El HTML en bruto, 43.837 tokens, queda fuera de la gráfica.
En bytes, la herramienta gana de calle: doce veces menos tráfico que la página. La página de precios dedica más del 96 % de su peso a marcado, scripts, estilos y datos de hidratación. No es un defecto de esta web en particular: es lo que hace cualquier aplicación moderna, y un agente que se tragara ese HTML en bruto gastaría 43.837 tokens para obtener poco.
En tokens, el resultado se da la vuelta. Una vez extraído el texto, la página son 1.172 tokens y la herramienta 1.779: un 52 % más. No es que la herramienta sea peor; es que responde más. Trae las tarifas de todos los países, los servicios y para quién no es cada uno, mientras que el HTML solo enseña la tarifa del país desde el que se pide. Para esta pregunta, lo que MCP aporta es un dato completo y canónico, no un ahorro de contexto.
Donde sí ahorra es en las preguntas estrechas. La página /glosario/geo-generative-engine-optimization deja 1.515 tokens de texto, y ese texto incluye el menú, las migas, los términos relacionados, la llamada a la acción y el pie. La herramienta consultar_glosario devuelve la definición corta y larga en 205 tokens, y nada más. Siete veces menos contexto para obtener exactamente el dato que se pidió.
Un matiz más: nuestras herramientas devuelven el texto y, además, los mismos datos en JSON (structuredContent). Si el cliente le pasa al modelo las dos cosas, servicios_y_precios sube a 3.040 tokens. Qué se pasa depende del cliente, no del servidor.
Lo que esta medición demuestra es el tráfico y el tamaño de cada respuesta. No demuestra que un agente responda mejor ni más rápido por una vía que por otra: eso exige comparar las respuestas, y no lo hemos medido. Los datos, con el método de cada fila, están en este CSV.
El coste fijo que casi nadie menciona
Antes de que esto suene a que MCP es gratis: no lo es.
Un cliente MCP pide el catálogo de herramientas al conectarse. Nuestro tools/list devuelve 26.147 bytes de esquemas JSON para cinco herramientas: 6.487 tokens. Lo que pase después depende del cliente. Si mete el catálogo entero en el contexto del modelo, ese coste se paga en cada conversación aunque no se llame a ninguna herramienta. Los clientes con búsqueda de herramientas o carga diferida —OpenAI y Anthropic la documentan en sus API— cargan solo las que van a usar.
Ese catálogo era casi cuatro veces más pequeño. El 20 de septiembre medía 6.861 bytes, con descripciones de entre 252 y 511 caracteres. El 28 de septiembre las reescribimos siguiendo la plantilla que premia el evaluador de legibilidad de mcpmetrics: que cada una diga cuándo usarla, cuándo no y qué usar en su lugar, qué devuelve y cuáles son sus límites. Ahora miden entre 982 y 1.928 caracteres. No hemos medido si eso hace que los modelos elijan mejor la herramienta; sí sabemos lo que cuesta. En un cliente que carga el catálogo entero, la primera pregunta sobre precios cuesta 8.266 tokens por MCP: siete veces lo que cuesta leer la página.
Con cinco herramientas se aguanta. Con cuarenta mal descritas y sin carga diferida, el servidor empeora al agente que lo instala —gasta contexto, aumenta la probabilidad de que elija la herramienta equivocada y ralentiza todo—. La propia documentación de WebMCP avisa de lo mismo para su caso: cada herramienta registrada consume tokens en el prompt del modelo, y recomienda no registrar decenas ni centenares.
Es la regla de diseño que se ignora sistemáticamente cuando alguien monta su primer servidor: pocas herramientas, descripciones que digan cuándo usarlas y cuándo no, respuestas pequeñas y el peso del catálogo medido. Un servidor MCP no es una API REST con otra sintaxis; en los clientes que cargan el catálogo entero, es un fragmento de prompt permanente.
Lo que no vamos a contarte, y por qué
Aquí toca ser explícito, porque el hueco se nota.
No vamos a enseñarte cuántas veces al día se llama a nuestro servidor MCP. El servidor registra una línea JSON por llamada —qué método y qué herramienta, sin IP, sin cookies y sin las URLs analizadas—, pero esas líneas van a los logs de ejecución de Vercel, que tienen una retención de horas: la API devuelve los últimos cien eventos y poco más. Publicar «X llamadas» a partir de una ventana de siete minutos sería exactamente el tipo de cifra que criticamos en otros.
Lo honesto es decir lo que hay: el servidor está publicado, activo en el registro oficial y funciona; la medición de uso agregado exige un log drain o un contador persistente que todavía no hemos montado. Cuando lo esté y haya un mes de datos, se publica —con el número que salga, incluido si es decepcionante—.
Y una advertencia comercial que vale por todo lo demás: un servidor MCP no se descubre navegando. Estar en el registro oficial lo hace encontrable para quien busca servidores desde un cliente o un directorio MCP, pero el usuario tiene que conectarlo, y ni Google ni ChatGPT Search lo usan como fuente por estar ahí. No es un canal de captación; es una herramienta para quien ya te conoce y una señal de entidad para quien evalúa si sabes de lo que hablas.
WebMCP: qué es de verdad, en octubre de 2026
Aquí es donde conviene ir a la fuente primaria, porque el contenido publicado sobre WebMCP está mayoritariamente equivocado en los detalles que importan.
La API es document.modelContext, no navigator.modelContext. Buena parte de los artículos que aparecen primero al buscar —incluidos varios que anuncian compatibilidad con navegadores concretos— usan el nombre de un borrador anterior. La especificación que mantiene el W3C Web Machine Learning Community Group define hoy document.modelContext.registerTool(), document.modelContext.getTools(), document.modelContext.executeTool() y un evento toolchange. Copiar el nombre viejo no registra nada: en un navegador sin esa propiedad, navigator.modelContext.registerTool() lanza un TypeError, y si el código usa encadenamiento opcional (navigator.modelContext?.registerTool()) la llamada se omite en silencio y lo descubres tarde.
Una herramienta se declara así, con nombre, descripción en lenguaje natural, esquema de entrada y una función que reutiliza el código que ya tiene la página:
if ("modelContext" in document) {
  await document.modelContext.registerTool({
    name: "filtrar_plantillas",
    description: "Filtra las plantillas visibles por tema y color de fondo",
    inputSchema: { /* JSON Schema de los parámetros */ },
    async execute({ tema, fondo }) {
      aplicarFiltros({ tema, fondo });   // el mismo código que usa el botón
      return { content: [{ type: "text", text: resumenDeResultados() }] };
    },
  });
}
La comprobación del principio no es decorativa: ningún navegador estable tiene la API, y sin ella la llamada lanza un TypeError que puede cortar el resto del script de la página.
Hay además una vía declarativa para exponer un <form> existente como herramienta, sin escribir JavaScript nuevo. Y un control de permisos por cabecera: Permissions-Policy: tools=() desactiva el registro, y registerTool() rechaza con NotAllowedError.
El estado real de implementación
| Navegador / agente | Estado comprobado el 19 de octubre de 2026 |
|---|---|
| Chrome | Origin trial desde Chrome 149, anunciado el 9 de junio de 2026. Flag local enable-webmcp-testing |
| Edge | Origin trial en Edge 150 |
| Brave | Soporte experimental en Leo |
| ChatGPT Desktop | Compatible en el navegador integrado de la app de escritorio, según el modelo y el despliegue («site tools»). En Enterprise lo tiene que permitir un administrador; en Edu no está disponible |
| Firefox | Posición de Mozilla: neutral (standards-positions #1412, agosto de 2026); Chrome Status aún dice «No signal» |
| Safari | Posición de WebKit: se opone (standards-positions #670, junio de 2026); Chrome Status aún dice «No signal» |
Y la clasificación oficial, que es la que desmonta los titulares: Chrome Status marca la función como «Proposed» y la madurez de la especificación como «Specification being incubated in a Community Group». Es decir: no está en la vía de estándar del W3C, ningún navegador lo ha enviado a estable, Mozilla se declara neutral y WebKit se opone.
Un origin trial es acceso anticipado con fecha de caducidad y límites de uso, pensado para recoger opiniones de desarrolladores. No es una función que puedas dar por disponible para tus usuarios.
Lo que sí conviene hacer hoy
Y aun así, hay trabajo que rinde ya, porque no depende de que la API se active.
Si diseñas tus formularios como si fueran herramientas —campos con nombres explícitos, valores enumerados en lugar de texto libre, estados de error legibles, una confirmación en texto de lo que ha ocurrido—, ese trabajo sirve en los tres escenarios: mejora la accesibilidad, mejora lo que un agente puede hacer hoy por actuación sobre el DOM, y es exactamente lo que WebMCP formalizará después. Lo desarrollamos en la guía agent-first para webs de servicios.
Lo que no conviene es reescribir la aplicación alrededor de una API en incubación que la mayoría de tus visitantes no puede ejecutar.
Cuál necesitas tú
| Tu situación | llms.txt | MCP | WebMCP |
|---|---|---|---|
| Web de servicios con formulario de contacto | Opcional, media hora | No | No, pero diseña el formulario como herramienta |
| Blog, medio o web de contenido | Opcional | No | No |
| Documentación técnica o base de conocimiento | Sí, aquí es donde más rinde | Sí, si hay búsqueda o API que consultar | No |
| SaaS con aplicación en cliente y sesión | Opcional; sí para la documentación | Sí, para la parte de backend | Sí, es tu caso: es para lo que se diseñó |
| Ecommerce | Opcional | Solo si tienes catálogo consultable | Sí, para filtros y carrito |
| Herramienta o calculadora propia | Opcional | Sí, es el caso más claro | Según dónde viva la lógica |
«Opcional» en la columna del llms.txt quiere decir exactamente eso: Google Search lo ignora y nadie ha demostrado que ayude a que te citen. Tiene sentido si lo vas a usar como contexto o si alguna herramienta que usas lo lee.
La fila que más gente quiere saltarse es la primera. Si tienes una web de servicios, tu trabajo no está en ninguna de las tres columnas: está en que el contenido diga algo concreto, en que se lea sin JavaScript y en que tu precio sea recuperable. Las tres capas presuponen eso, y ninguna lo arregla.
El coste que se paga después: contenido paralelo
Hay un riesgo que comparten las tres y que no aparece en ningún tutorial: cada capa nueva es una copia más de la verdad que alguien tendrá que mantener sincronizada.
Un llms.txt escrito a mano se queda obsoleto el día que cambias de precios. Un servidor MCP con las descripciones de servicio copiadas y pegadas empieza a contradecir a la web en la primera actualización. Una herramienta WebMCP que duplica la lógica de un botón se rompe cuando el botón cambia. Y lo peor de la desincronización no es el error: es que la vía que solo leen las máquinas es la que nadie revisa, así que el error puede vivir meses.
La única forma de que esto no pase es estructural: una sola fuente, tres salidas. En esta web, los precios, los servicios y las preguntas frecuentes viven en un único módulo de constantes del que se alimentan a la vez la página, el llms.txt y la herramienta MCP. Cambiar un precio es cambiar un número en un sitio. Si tu implementación requiere acordarse de actualizar tres ficheros, no la montes: el día que se olvide alguien —y se va a olvidar— estarás dándole a un agente datos que tu web desmiente.
Ese principio, y no la elección de protocolo, es lo que separa una infraestructura para agentes que aguanta de una que se pudre en seis meses.
Qué haría yo en tu web esta semana
En este orden, y parando en cuanto se acabe el presupuesto:
- Comprueba que tu contenido existe sin JavaScript.
curla tu página principal y a una de servicio, y mira si lo esencial —qué haces, para quién y a qué precio— está en el HTML que llega. Google ejecuta JavaScript para indexar, pero no todos los rastreadores y agentes de IA lo hacen: para los que leen solo el HTML inicial, lo que no está ahí no existe. Puedes hacerlo con el escáner gratuito en diez segundos. - Comprueba el acceso real de los bots, no la política declarada. Que
robots.txtlos permita no significa que tu WAF los deje entrar. Esto es lo primero que miramos en una auditoría y lo que más veces aparece roto. - Publica el precio, o el rango. Si un agente no lo encuentra en tu web, lo busca en un directorio que tú no controlas.
- Si haces el llms.txt, genéralo desde tu fuente de datos, no a mano. Es opcional: media hora, valor incierto, coste de mantenimiento cero si se hace bien.
- Rediseña un formulario como herramienta. Campos nombrados, valores enumerados, confirmación en texto. Sirve hoy y servirá cuando WebMCP salga de incubación.
- Monta un servidor MCP solo si tienes una función que ofrecer. Pocas herramientas, descripciones que digan cuándo usarlas y cuándo no, respuestas pequeñas, y mide lo que pesa el catálogo. Si lo único que ibas a exponer es tu catálogo de servicios en texto, eso ya está en tu web.
La pregunta con la que empieza este artículo tiene respuesta, y para la mayoría de los negocios es incómoda por lo aburrida: probablemente no necesitas ninguna de las tres todavía. Lo que necesitas es que lo que ya tienes se pueda leer. Las tres capas sirven para que un agente trabaje mejor con tu contenido; ninguna sirve para que haya contenido.
Fuentes
- Chrome for Developers — Origin trial de WebMCP en Chrome 149 (9 de junio de 2026) y documentación de WebMCP.
- Microsoft Edge — Notas de la versión 150: origin trial de WebMCP.
- Chrome Status — ficha de WebMCP: «Proposed», «Incubation».
- W3C Web Machine Learning Community Group — borrador de la especificación de WebMCP y estado de implementación.
- Posiciones de los motores: Mozilla #1412 (neutral) y WebKit #670 (se opone).
- Model Context Protocol — versionado de la especificación (revisión 2026-07-28) y registro oficial.
- Ahrefs — estudio sobre llms.txt (datos de mayo de 2026, publicado el 15 de junio).
- Google Search Central — guía de optimización para las funciones de IA generativa: Google Search no usa los ficheros llms.txt.
- Carga diferida de herramientas: OpenAI, tool search, y Anthropic, tool search tool.
- WebMCP — buenas prácticas sobre el presupuesto de herramientas y WebMCP en ChatGPT.
- Datos propios — medición del 19 de octubre de 2026 en CSV: bytes, caracteres y tokens de cada vía.
Preguntas frecuentes
Responden a tres preguntas distintas. El llms.txt es un fichero de texto estático que describe qué hay en tu web: sirve para que un modelo que ya está leyendo entienda tu sitio, y su uso real es como contexto pegado a mano, no como algo que los crawlers pidan solos. MCP es un servidor remoto que expone acciones de tu backend a un agente que no está en tu web: el agente llama a una herramienta con parámetros y recibe datos estructurados. WebMCP es una API del navegador —`document.modelContext`— con la que tu página declara qué puede hacer un agente dentro de la pestaña, con la sesión del usuario ya iniciada. Leer, llamar y actuar: tres capas que no se sustituyen.
No en estable, a fecha de octubre de 2026. Chrome tiene un origin trial abierto desde Chrome 149 (anunciado el 9 de junio de 2026) y Edge otro en Edge 150; Brave lo tiene experimental en Leo y la app de escritorio de ChatGPT lo usa en su navegador integrado, según el modelo y la cuenta. Chrome Status clasifica la función como «Proposed» y la especificación como «Specification being incubated in a Community Group»: sigue en incubación en el W3C Web Machine Learning Community Group, no en la vía de estándar. Mozilla ha fijado una posición neutral y WebKit (Safari) se opone a la propuesta, aunque Chrome Status aún los muestra como «No signal». Un origin trial es acceso anticipado con fecha de caducidad, no una función disponible para tus usuarios.
`document.modelContext`. Buena parte de los artículos publicados sobre WebMCP —incluidos varios que aparecen primero en las búsquedas— siguen escribiendo `navigator.modelContext`, que fue la forma de un borrador anterior. La especificación actual del repositorio del W3C Web Machine Learning Community Group usa `document.modelContext.registerTool()`, `getTools()` y `executeTool()`, más un evento `toolchange`. Si copias el nombre equivocado, no registras nada: en un navegador sin esa propiedad, `navigator.modelContext.registerTool()` lanza un `TypeError`, y con encadenamiento opcional (`navigator.modelContext?.registerTool()`) la llamada se omite en silencio, que es peor porque no te enteras.
Solo si tienes algo que un agente pueda hacer y que no sea leer. Si todo lo que ofreces es información —quiénes sois, qué servicios, qué precios—, eso ya cabe en HTML bien estructurado y en el llms.txt, y montar un servidor MCP no añade visibilidad. Un servidor MCP tiene sentido cuando expones un cálculo, una consulta a tus datos o una operación: un escáner, un buscador sobre tu catálogo, una disponibilidad. Y con una advertencia comercial importante: publicarlo en el registro oficial de MCP lo hace encontrable para quien busca servidores desde un cliente o un directorio MCP, pero no hace que Google ni ChatGPT Search lo usen como fuente. Es una herramienta de fidelización y de credibilidad técnica, no un canal de captación.
No hay ninguna evidencia de que lo haga, y conviene decirlo antes de que alguien te lo venda. Un servidor MCP no lo rastrea ningún crawler, no entra en el índice de ningún buscador —el registro oficial de MCP es un directorio para clientes MCP, no para buscadores— y no influye en lo que un modelo responde sobre tu marca a quien no lo haya conectado. Lo que sí hace es distinto y medible: para el usuario que lo instala, convierte tu web en una fuente consultable con datos canónicos en lugar de una página que hay que raspar. El beneficio de visibilidad, si llega, es indirecto: estar en el registro oficial de MCP y en los directorios es una señal de entidad más, del mismo tipo que un perfil bien mantenido.
Depende de la pregunta, y a veces nada. Lo medimos contra producción el 19 de octubre de 2026, en tokens y no solo en bytes. Para responder «qué servicios hay y cuánto cuestan», la página `/precios` pesa 152.007 bytes, pero una vez extraído el texto quedan 1.172 tokens; la herramienta `servicios_y_precios` devuelve 1.779, porque trae las tarifas de todos los países. Doce veces menos tráfico, pero más contexto. Para una definición del glosario sí gana MCP: 205 tokens frente a 1.515 de la página. Y hay un coste fijo: el catálogo de cinco herramientas son 6.487 tokens si el cliente lo carga entero; los clientes con carga diferida solo cargan las herramientas que van a usar.
Por el HTML. Las tres capas presuponen que el contenido existe, es legible sin JavaScript y dice algo concreto; ninguna de ellas arregla una web que no se puede leer. Cuando eso esté resuelto, el orden por relación coste/beneficio es: contenido extraíble y schema, después, si quieres, llms.txt (barato y opcional: Google Search lo ignora y ninguna plataforma ha confirmado que lo use), después WebMCP declarativo si tienes formularios de verdad —diseñar el formulario como una herramienta con campos nombrados y valores enumerados sirve igual aunque nunca actives la API— y, por último, un servidor MCP si tienes una función que ofrecer.
Decidir cuál de las tres necesitas es media hora. Implementarla bien es el trabajo.
Trabajamos la capa técnica de visibilidad en motores generativos de punta a punta: acceso real de los crawlers, extractibilidad por plantilla, señales de entidad y —cuando tiene sentido— la infraestructura para agentes. Con el criterio para no montar lo que no vas a mantener.
Ver el servicio de agencia GEOFOUNDER & SEO LEAD
Founder de Autoridad Digital. Especialista en SEO, Generative Engine Optimization, Topical Authority y Authority Stacking, PR Digital. Todos los artículos del blog están firmados por él.
¿Te resulta útil este contenido? Añádenos como fuente preferida en Google.
Activa las cookies de terceros (Google) para ver este botón.