Código, sitemap y rastreo: los 7 estados de una URL y los 4 que un crawler normal no ve
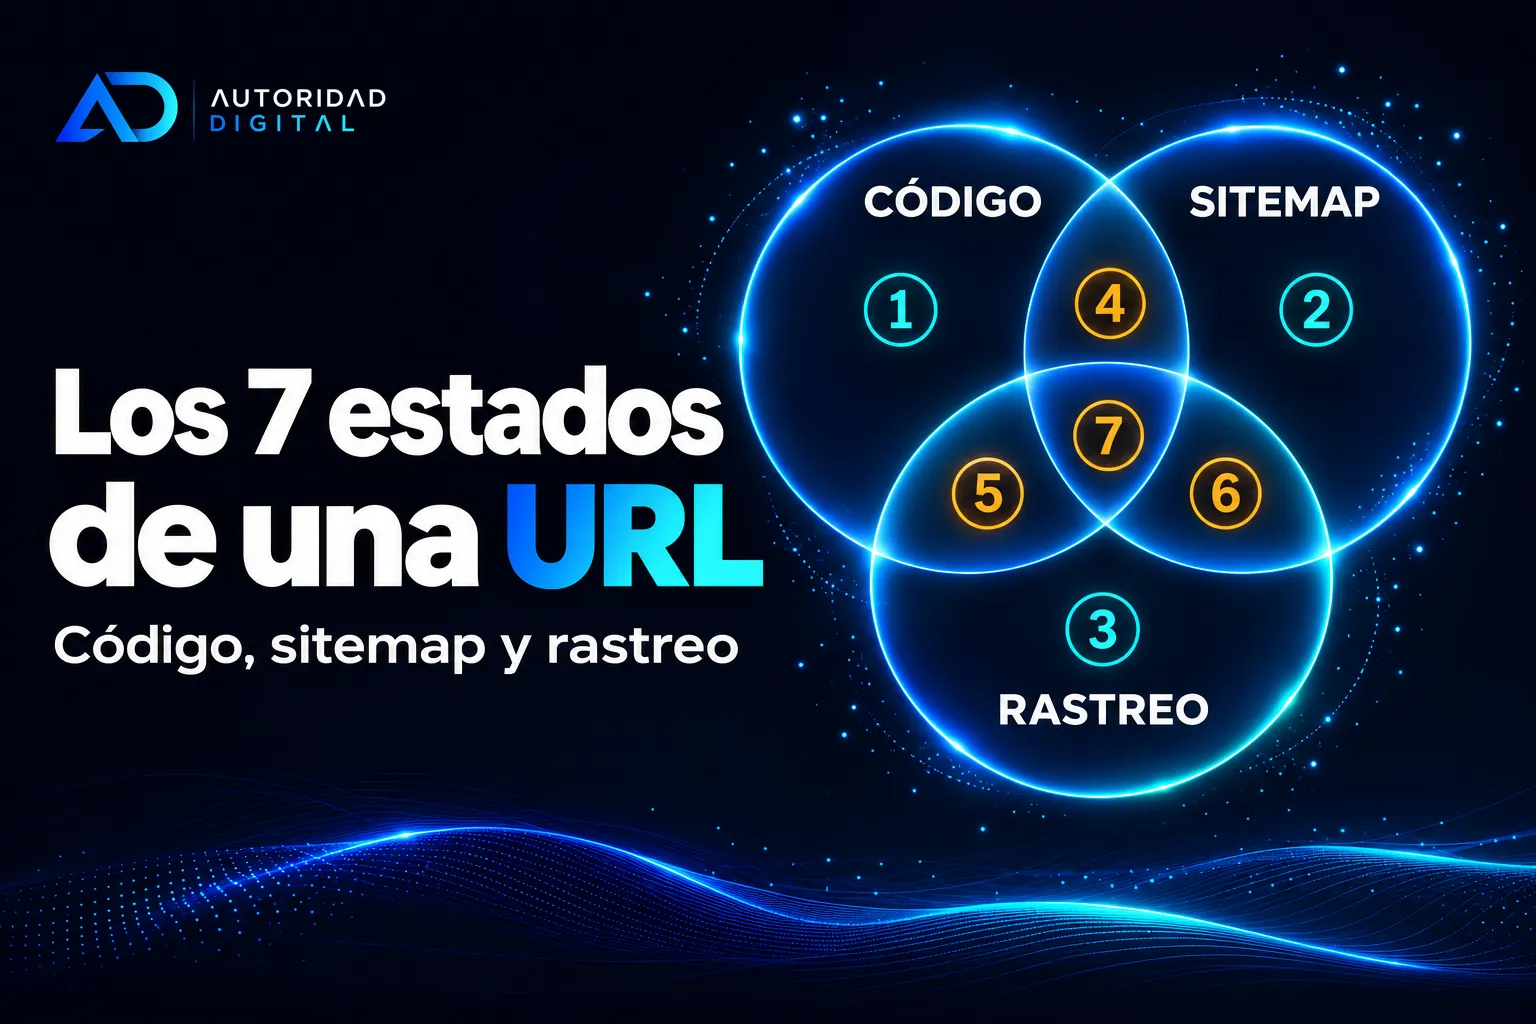
Cruzar el código, el sitemap y el rastreo de una web da siete estados por URL, y cuatro solo se ven leyendo el código. Los explicamos con nuestra propia web: 27 URLs fuera de lo normal, ningún fallo real y una decisión pendiente.
Resumen ejecutivo
- Una web tiene tres listas de URLs que deberían coincidir: las que genera el código, las que declara el sitemap y las que se alcanzan navegando desde la página de inicio. Casi nunca coinciden del todo.
- Cruzar las tres da siete estados posibles. Un rastreador normal ya cruza sitemap y navegación; cuatro de los siete solo se distinguen leyendo el código.
- En el rastreo de nuestra propia web del 10 de octubre de 2026, 27 de 106 URLs salieron fuera del estado «todo bien». Ninguna era un fallo de la web.
- De esas 27, 12 eran errores de lectura de nuestro motor, 5 eran correctas e intencionadas y 10 nos obligan a tomar una decisión que teníamos pendiente sin saberlo.
- La lección: un estado no es un veredicto. Es una pregunta, y el valor del método está en que te la hace.
Tres listas que deberían coincidir
Cualquier web tiene, aunque nadie lo haya escrito nunca, tres inventarios de sus propias páginas.
- El código. Las rutas que existen porque alguien las programó: una carpeta por página, una plantilla que genera una URL por cada artículo, un fichero técnico servido en una ruta fija.
- El sitemap. Lo que la web le dice a los buscadores que tiene y que quiere que indexen.
- El rastreo. Lo que encuentra quien entra por la página de inicio y sigue los enlaces, como hace un buscador o un rastreador de IA, y lo que responde de verdad.
En una web recién publicada las tres listas coinciden. Con el tiempo se separan: se borra una página pero el sitemap la sigue declarando, se crea una landing para una campaña y nadie la enlaza, se migra una sección y la URL antigua sigue viva. Cada separación es invisible desde cada lista por separado. Solo aparece al cruzarlas.
Lo que un rastreador normal ya hace
Conviene ser justos con las herramientas que ya existen. Screaming Frog, el rastreador SEO más usado, cruza el rastreo con el sitemap y marca como huérfanas las URLs que están en el sitemap pero a las que no lleva ningún enlace. También puede añadir las URLs que aparecen en Google Analytics y en Search Console para encontrar huérfanas que el sitemap no declara (documentación de Screaming Frog, consultada en octubre de 2026).
Eso cubre dos de los tres ejes. Lo que ninguna herramienta que trabaja desde fuera puede saber es qué dice el código. Y sin el código, cuatro de los siete estados se disfrazan de otros.
Los siete estados
| Código | Sitemap | Rastreo | Estado | La pregunta que te obliga a hacerte |
|---|---|---|---|---|
| ✓ | ✓ | ✓ | Todo bien | Ninguna. |
| ✓ | ✓ | ✗ | No alcanzable | ¿Por qué ninguna página enlaza a esta? |
| ✓ | ✗ | ✓ | Falta en el sitemap | ¿Debería indexarse? |
| ✓ | ✗ | ✗ | Fantasma | ¿Alguien sabe que esta página existe? |
| ✗ | ✓ | ✗ | Sitemap obsoleto | ¿Por qué declaramos algo que ya no existe en el código? |
| ✗ | ✓ | ✓ | Ruta heredada | ¿Qué está sirviendo esta URL si ya no está en el código? |
| ✗ | ✗ | ✓ | URL inesperada | ¿De dónde sale esto? |
Los dos primeros problemas de la tabla, «no alcanzable» y «falta en el sitemap», los ve cualquier rastreador. Los otros cuatro son los que necesitan el código:
- La fantasma no la ve nadie. No está en el sitemap y nadie la enlaza, así que un rastreador externo no tiene forma de llegar a ella. Puede ser una página olvidada, una prueba que se quedó en producción o un panel que no debería ser público.
- El sitemap obsoleto se confunde con una huérfana. Desde fuera, una URL del sitemap a la que nadie enlaza parece una página que falta enlazar. Con el código delante se ve la diferencia: si la página ya no existe en el código, la solución no es enlazarla sino quitarla del sitemap.
- La ruta heredada parece sana. Está en el sitemap y responde, así que un rastreador externo la da por buena. Pero si el código ya no la genera, algo la está sirviendo por otra vía: una redirección vieja, una caché, una configuración del servidor que nadie recuerda.
- La URL inesperada se confunde con una que falta en el sitemap. Las dos responden y no están declaradas. La diferencia es que la segunda la generó el código a propósito y la primera no se sabe de dónde viene.
El cruce aplicado a nuestra propia web
Nuestro motor de auditoría hace este cruce cada semana sobre una veintena de webs. El rastreo de autoridaddigital.com del 10 de octubre de 2026 comprobó 99 URLs y añadió 7 que solo existían en el código: 106 en total. Este fue el reparto:
| Estado | URLs |
|---|---|
| Todo bien | 79 |
| No alcanzable | 10 |
| Fantasma | 7 |
| Sitemap obsoleto | 4 |
| Ruta heredada | 3 |
| Falta en el sitemap | 2 |
| URL inesperada | 1 |
Veintisiete URLs fuera de «todo bien» en una web que cuida su SEO técnico. Las revisamos una a una contra el código y contra la web publicada. Esto es lo que eran.
12 eran errores de lectura del motor
Ocho eran los mismos cuatro artículos contados dos veces. Tenemos cuatro artículos en inglés que viven en el mismo directorio que los españoles pero se publican en /en/insights/. Al motor le habíamos dicho que cada fichero de ese directorio es una URL bajo /blog/. Resultado: cuatro fantasmas en /blog/… que en realidad dan 404, como debe ser, y las cuatro URLs reales de /en/insights/… marcadas como sitemap obsoleto porque el motor no las encontraba en el código. El fallo estaba en la descripción que le dimos al motor, no en la web.
Tres eran reescrituras. La página de inicio, /metodo y /precios salían como rutas heredadas, es decir, vivas pero fuera del código. Están en el código, pero no donde el motor las buscaba. Las tres muestran precios según el país del visitante, y para no generar una página dinámica en cada visita se sirven desde versiones ya generadas por país mediante una reescritura interna. El motor lee las carpetas de rutas y no las reescrituras, así que no encontró ningún fichero para esas tres URLs.
Una era un fichero estático. El CSV con los datos de nuestro estudio de 584 webs de LATAM salía como URL inesperada. Lo enlaza el propio artículo y está en el repositorio, pero en la carpeta de ficheros estáticos, que el motor no recorre.
5 eran correctas e intencionadas
security.txt, el fichero de verificación del registro MCP y el feed RSS salían como fantasmas: están en el código, no en el sitemap y ninguna página los enlaza con un enlace normal. Es exactamente lo que deben ser. Son ficheros para máquinas que los buscan en una ruta conocida, y no deben indexarse.llms.txtyllms-full.txtsalían como «falta en el sitemap». También es lo correcto: son ficheros para modelos de lenguaje, no páginas para indexar. Lo explicamos en para qué sirve de verdad llms.txt.
Aquí el motor acertó en la clasificación y la clasificación no indica ningún problema. Por eso el estado no basta: hace falta alguien que sepa qué hace cada URL.
10 nos obligan a decidir algo
Las diez URLs «no alcanzables» son la sección en inglés de la web: la portada, los servicios, el contacto, el escáner, los artículos y los textos legales. Están en el código y en el sitemap, responden bien, y ninguna página en español enlaza a ellas. La portada declara su versión inglesa con hreflang, que es la etiqueta con la que se indica a los buscadores qué página equivale a cuál en otro idioma, pero eso no es un enlace que un visitante pueda pulsar ni que un rastreador siga como navegación.
¿Es un fallo? Depende de una decisión que no habíamos tomado de forma explícita. La sección en inglés se dirige a otro mercado. Si queremos que sea una web aparte para ese público, que llega por otros canales, está bien así. Si queremos que comparta la autoridad del dominio, le falta al menos un enlace visible desde la parte española. El motor no puede decidirlo. Lo que sí hizo fue ponerlo encima de la mesa, y sin él no lo habríamos visto: desde dentro de la web española no hay ningún camino que lleve hasta ella.
Tres lecciones que valen para cualquier web
1. El eje del código es tan bueno como la descripción del código
Todos los errores de lectura vinieron del mismo sitio: el motor no sabía cómo genera URLs la web. Un fichero de contenido no siempre se publica donde parece, una reescritura sirve una URL desde otro sitio y la carpeta de estáticos también publica ficheros.
En el mismo barrido del 10 de octubre se ve a mayor escala. En tres webs propias cuya configuración generamos de forma automática, sin describir sus rutas dinámicas, la columna de rutas heredadas salió con 49 URLs en NVDigital, 103 en Loco 22 y 131 en Alternativa Bursátil. Las que revisamos de NVDigital y Loco 22 eran artículos, categorías, fichas de autor, páginas por ciudad y entradas de glosario: páginas que el código genera a partir de datos y que el motor no supo atribuirle. No son rutas heredadas. Son una configuración sin terminar.
Por eso, en una auditoría, el primer paso del cruce no es rastrear. Es sentarse con el código y apuntar cómo genera URLs: qué carpetas, qué plantillas, qué datos, qué reescrituras. Si ese paso se salta, el informe se llena de alarmas falsas.
2. Un estado no es un veredicto
security.txt es una fantasma de manual y debe seguir siéndolo. Un informe que convierte cada estado en un error con prioridad alta te hará perder el tiempo, o algo peor: que alguien meta en el sitemap ficheros que no deben estar en él. Cada estado viene con una pregunta, y la respuesta a veces es «está bien así». Contarlo también forma parte del informe. Lo explicamos en las diez preguntas para leer un informe de auditoría.
3. Lo valioso es lo que no sabías que tenías que decidir
En nuestro caso no apareció ningún fallo, y aun así el ejercicio valió la pena por las diez URLs en inglés. No es un error técnico: es una decisión de negocio que el código había tomado por omisión. Ese es el tipo de hallazgo que una herramienta automática no puede resolver y que un buen auditor no debería resolver por ti. Te lo enseña con la evidencia y te dice qué implica cada opción.
El motor también se equivocó al empezar
Este método nos ha hecho corregir antes el motor que las webs. En su primera ejecución, a finales de agosto, contra esta misma web, encontró dos errores propios antes que ninguno del sitio:
- La página de inicio aparecía duplicada como huérfana. El sitemap la declaraba sin barra final y el rastreo la visitaba con barra, y el motor las trató como dos URLs distintas.
llms.txtyllms-full.txtsalían como no declaradas en el código, porque el motor solo reconocía las rutas que pintan una página y no las que devuelven un fichero.
Los dos se corrigieron con su prueba automática antes de dar el rastreo por bueno. Después quedaron 70 URLs limpias como línea base. Desde entonces la web ha crecido hasta las 106 del rastreo del 10 de octubre, y con ella han aparecido los casos que el motor no sabía leer: los artículos en inglés y los precios por país.
No lo contamos por modestia. Lo contamos porque es la forma honesta de usar cualquier herramienta de auditoría, nuestra o ajena: cada hallazgo se comprueba antes de convertirlo en tarea. Ya lo medimos en otro contexto: al volver a comprobar 40 auditorías nuestras pocos días después, una de cada cuatro contenía un dato que había dejado de ser cierto.
Cómo hacer el cruce sin un motor propio
No hace falta una herramienta como la nuestra para aprovechar la idea. Hace falta paciencia y una hoja de cálculo.
- Saca la lista del código. En una web a medida, recorre las rutas: cada página fija, y para cada ruta dinámica, la fuente de datos que la alimenta (ficheros de contenido, base de datos, una lista en el código). No olvides las reescrituras, las redirecciones y la carpeta de ficheros estáticos. Si no sabes leer el código, pídeselo a quien lo mantiene: es una pregunta razonable y su respuesta ya es información.
- Descarga el sitemap y extrae todas las URLs, incluidas las de los sitemaps hijos si hay un índice.
- Rastrea desde la página de inicio siguiendo solo enlaces. Screaming Frog lo hace gratis hasta 500 URLs.
- Junta las tres listas con una columna por fuente y marca en cuáles aparece cada URL. Normaliza antes las URLs (barra final, mayúsculas,
www) o tendrás el mismo error que tuvo nuestro motor el primer día. - Revisa primero las fantasmas y las rutas heredadas. Son las más raras y las que más sorpresas dan, desde páginas de prueba publicadas hasta paneles internos accesibles.
Si tu web es un WordPress, el primer paso cambia: las páginas no están en el código sino en la base de datos. Exporta la lista de entradas y páginas publicadas y úsala como primera lista. Pierdes la parte de las reescrituras y las rutas que el código genera por su cuenta, pero conservas lo esencial.
Lo que no te contamos
No publicamos el código del motor ni cómo se configura. Lo usamos en las auditorías y todavía estamos aprendiendo dónde se equivoca, como muestra este artículo. Lo que sí publicamos es el método, que es lo que te sirve para exigirlo, o para comprobarlo, en cualquier auditoría que encargues.
Si quieres una primera mirada a tu web antes de encargar nada, nuestro escáner GEO revisa en segundos lo básico que ve un rastreador de IA. No cruza el código, eso necesita acceso al repositorio, y te lo dice.
Preguntas frecuentes
Una página que existe y responde, pero a la que no lleva ningún enlace interno: solo se llega a ella si conoces la URL, la encuentras en el sitemap o aparece en Search Console. Para Google es una señal de poca importancia, y para un usuario es una página que no puede encontrar navegando. Los rastreadores SEO habituales la detectan cruzando el rastreo con el sitemap, Google Analytics o Search Console.
Es el nombre que usamos para una ruta que existe en el código de la web pero que no aparece en el sitemap ni se alcanza navegando. Puede ser una página olvidada, una ruta de pruebas que se quedó en producción o un fichero técnico que debe estar ahí, como security.txt. Ningún rastreador que trabaje solo desde fuera la ve, porque nadie la enlaza ni la declara.
No. El sitemap debe listar las páginas que quieres que los buscadores indexen. Ficheros como robots.txt, llms.txt, el feed RSS o los de la carpeta .well-known no van en él, y que falten no es un error. Por eso un estado como «falta en el sitemap» es una pregunta que hay que contestar, no un fallo automático.
Solo en parte. En WordPress las páginas no están en el código sino en la base de datos, así que el eje del código pierde casi todo su valor: lo útil es cruzar la lista de contenidos publicados con el sitemap y el rastreo. Donde este método da más es en webs hechas a medida, por ejemplo con Next.js o Astro, en las que el código decide qué URLs existen.
Sí, con más trabajo manual. Necesitas tres listas: las rutas que genera el código, las URLs del sitemap y las que encuentra un rastreador desde la página de inicio. Con las tres en una hoja de cálculo, cada URL cae en una de las siete combinaciones. Lo difícil es la primera lista, porque hay que saber cómo genera URLs la web: rutas dinámicas, contenidos en ficheros, reescrituras.
¿Quieres saber qué hay en tu web que nadie ve?
Nuestra auditoría GEO cruza tu código, tu sitemap y lo que encuentra un rastreador, y entrega cada hallazgo con su evidencia y con lo que no se pudo medir. Sin permanencia.
Ver la auditoría GEOFOUNDER & SEO LEAD
Founder de Autoridad Digital. Especialista en SEO, Generative Engine Optimization, Topical Authority y Authority Stacking, PR Digital. Todos los artículos del blog están firmados por él.
¿Te resulta útil este contenido? Añádenos como fuente preferida en Google.
Activa las cookies de terceros (Google) para ver este botón.